事故管理流程图表达团队如何协调服务故障:记录影响、分类分级、找到响应人、同步状态并恢复服务。技术排查只是其中一个活动,不能代替协调流程。
下面是可定制的服务运维示例。先约定团队自己的分级与升级政策;图本身不会呼叫值班人员、执行 SLA 或替代响应系统。
事故管理流程,一步步来
下面是一个标准的事故流程。每个编号步骤是图里的一个形状,判断处就是分支。这是协调视角——技术排查发生在第 7 步内部,它有自己的故障排查流程图。
1. 检测或上报事故。 入口——告警触发、监控跳闸,或用户报告出了问题。这是开始终止符。
2. 记录事故。 开一条事故记录,写上时间戳、上报人和症状。应立即建立记录并随响应持续更新,但记录工作不能拖延紧急缓解。
3. 评估严重程度(判断)。 「这有多严重——P1、P2 还是 P3?」影响范围决定严重程度,而严重程度决定后续一切:谁被呼叫、多快、沟通多广。P1(重大停机)和 P3(轻微、单用户)走的路完全不同。
4. 需要立即响应吗?(判断) 对 P1,答案是「是」——立刻拉起作战室并呼叫值班。对较低级别,事故可以排到下一个工作时段。正是这个分支,让每条告警不至于把整个团队都吵醒。
5. 通知相关方 / 拉起作战室。 指定一名事故指挥官,拉进合适的响应人,开一个专用频道或会议桥。同时更新状态页,别让客户和支持团队干等着猜。
6. 同步状态。 定期发更新——发给作战室、发给管理层、通过状态页发给客户。沟通在这里是一等步骤,不是事后补的;它和下面的技术工作并行进行。
7. 诊断与缓解。 响应人处理技术问题:找出哪里坏了,施加一个缓解措施(回滚、故障转移、功能开关)。故障排查就发生在这里——见专门的流程。
8. 缓解了吗?(判断)
- 是 → 进入恢复。
- 否 → 升级:拉进更多响应人、提高严重程度,或叫上供应商,然后回到诊断。
9. 恢复服务。 确认服务健康、影响已消除。把状态页更新为「监控中」,再到「已解决」。
10. 关闭事故。 记录解决方案、时间线和影响,然后关闭记录。向相关方同步「警报解除」。
11. 复盘(回顾)。 事情平息后,开一次无责复盘:发生了什么、为什么、有哪些行动项能防止再次发生。这些反过来用于改进检测、加快下次响应。
两个判断处——严重程度评估,以及带升级环的「缓解了吗?」——正是把这变成一套事故「流程」而非一厢情愿的关键。打开流程图模板画出它,按你团队的分级改严重程度等级。
走查一次局部故障
虚构订单服务仍能接单,但确认邮件发不出去。先记录受影响流程、首次发现时间和已知范围,分类找到责任团队,再结合影响与紧迫程度分级。接单成功不代表用户体验已经恢复。
响应负责人协调排查,沟通负责人并行更新状态。若重试队列解决问题,应同时检查新订单与积压邮件再确认恢复;若未解决,升级出口必须指明下一位响应人,并回到排查。两条路径都持续更新记录。
恢复确认后记录解决方法和剩余任务。长期根因与预防可继续进入独立问题记录。故障排查流程图解释技术推理,这里负责协调与归属。
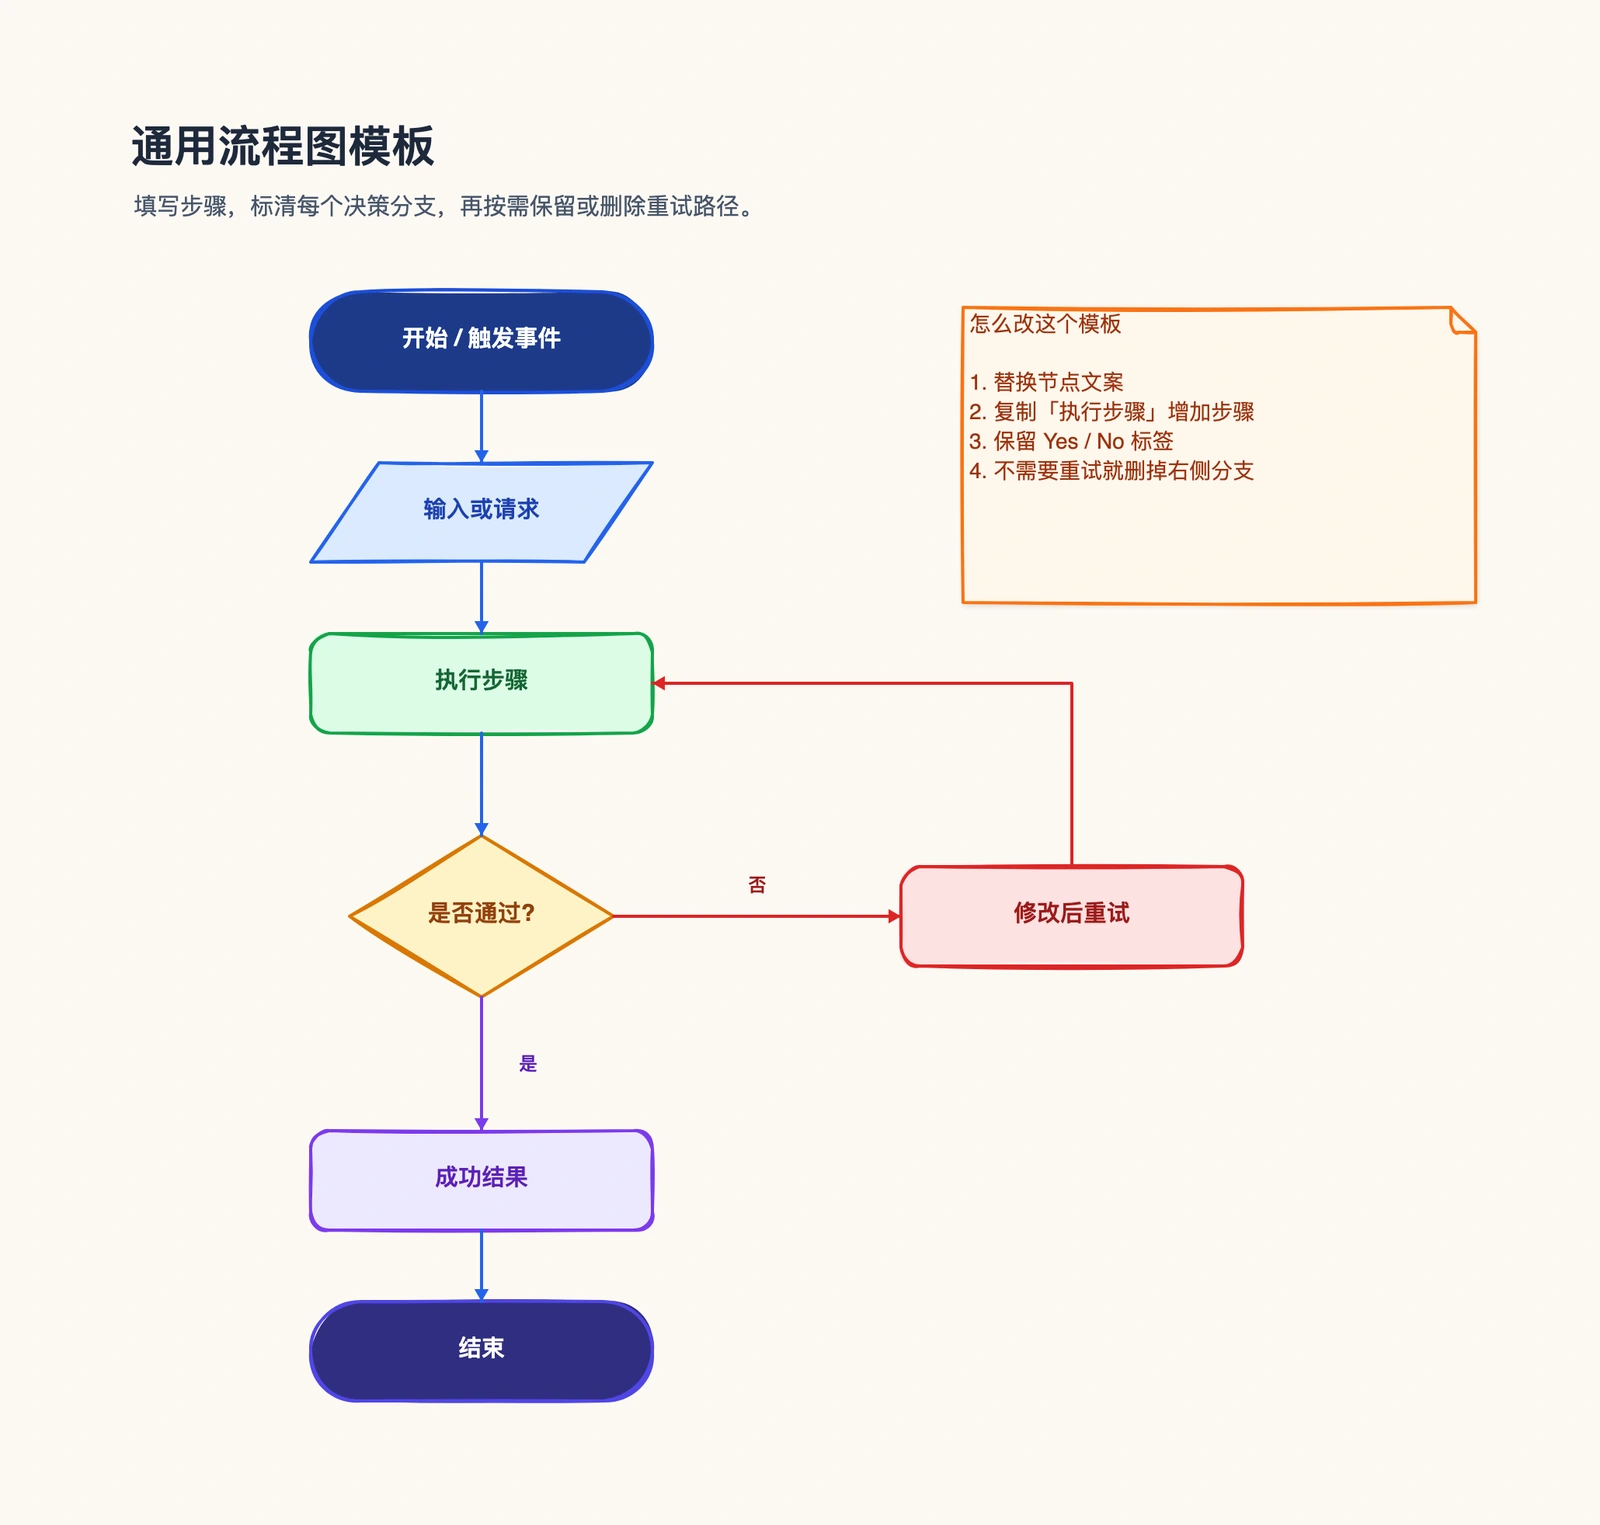
可以打开下面的通用模板,先把触发节点改成事故信号,把判断改成“恢复检查是否通过?”,再补上你们服务的响应负责人、沟通路径和升级回路。模板只是绘图起点,不会监控服务或自动处置事故。
响应职责与严重程度
事故负责人统筹决策,沟通负责人同步内外状态,专业响应人调查和缓解,记录人维护时间线。小团队可由同一人兼任,但必须明确谁负责。
全文统一使用示例 P1、P2、P3:P1 可表示关键客户任务不可用且无替代方案,P2 表示显著降级或局部中断,P3 表示影响有限且有可行替代。它们不是 ITIL 统一等级,要按业务影响、紧迫性和服务承诺判断。
不是 P1 也不等于可以等到明天。应写明谁可调整等级、何种信息触发复评,以及团队约定的沟通节奏;不要把十五分钟或三十分钟写成通用标准。
常见变体
不是每个团队都用同一套事故流程。几个常加的分支:
- On-call 轮值。 在「通知相关方」之前,很多流程会加一个「谁在值班?」的路由步骤,呼叫当前轮值而非固定某人。
- 按严重程度的 SLA。 每个严重程度有自己的响应和解决时钟。流程可以按严重程度分支到不同的通知和更新节奏。
- 对外状态页。 对面向客户的系统,加一个明确的「发布到状态页」步骤(及后续更新),让对外沟通在压力下不被遗忘。
- 无责复盘。 对 P1/P2,复盘是强制的并指派行动项;对低级别事故,可以跳过或并入每周回顾。
常见错误
没有严重程度分级。 如果每个事故都走同一条路,你要么对小抖动过度响应,要么对真停机响应不足。严重程度判断正是把响应「按需配置」的关键。
没有沟通分支。 只画技术修复的团队,会把客户和管理层晾在黑暗里。沟通和状态页值得有自己的步骤,与诊断并行。
跳过复盘。 关闭事故却不回顾,意味着同样的停机会再次发生。复盘步骤正是把一次事故变成永久改进的关键。
判断分支没标注。 每个菱形(「P1、P2 还是 P3?」「缓解了吗?」)都需要标注出路,否则响应人只能在压力下猜。
常见问题
什么是事故管理流程图?
事故管理流程图描绘一个组织如何协调对一次事故的响应——检测、记录、严重程度分级、通知、诊断与缓解、恢复、关闭和复盘——让整个团队一致地响应。
事故管理和故障排查有什么区别?
故障排查是工程层面找出并修复技术根因的工作。事故管理是围绕它的协调层——严重程度划分、谁被通知、状态如何对外沟通,以及事后的复盘。技术那一面见故障排查流程图。
想梳理自己的事故流程?打开流程图模板——把严重程度等级、升级环和沟通步骤改成你团队的样子,无需注册。
相关阅读
关闭前检查恢复关口
局部故障按受影响区域或用户组写具体验证条件。总指标恢复不代表该组已能完成任务,记录观察窗口、核验者和通知客户的人。
缓解失败回到带新证据的活跃响应,不回到丢失记录的空起点。恢复后区分现场响应关闭与复盘行动完成,后续任务有负责人和复查日,不要求所有人一直停留紧急模式。


