AI 漫剧制作流程可以拆成八步:明确单集目标、写可见的剧本、确认人物与场景参考、拆分镜并计时、逐镜生成素材、粗剪、按原因返工、整理交付。先确定观众需要看懂什么,再决定用哪个模型生成。
下面用原创虚构故事《最后一趟投递》规划一集 60 秒竖屏漫剧:车站快递员林发现旅客落下包裹,必须在赶车和物归原主之间选择。文中的剧本、时间分配和审核记录都是教学示例,没有声称已经生成成片,也不作为成本或收益案例。
第一步:先把这一集的任务说清楚
一句“做个好看的 AI 漫剧”无法判断结果是否合格。先写一张制作简报:两名成年角色、一个站台、一件包裹、一列黄色列车和一个青绿色挎包。故事只围绕林的一次选择展开,不临时增加人群、追逐或额外世界观说明。
| 决定 | 本例的明确答案 |
|---|---|
| 观众体验 | 一个善意举动,带出一个新的谜团 |
| 计划格式 | 竖屏,成片目标 60 秒 |
| 核心选择 | 上车,还是归还包裹 |
| 选择代价 | 林为还包裹错过列车 |
| 结尾信息 | 包裹里的钥匙缺口与林的包扣相同 |
| 审核问题 | 没有旁白,观众能否看懂他为什么错过车? |
有了这个边界,漂亮的车站空镜也可能被删,因为它挤掉了做选择的时间。第三个说话角色也不是自动加分,它会带来新的声音、外观和镜头交接需求。
还要区分静态漫画、带轻微动态的漫画视频和有连续动作的动画短剧。三者需要的时间、运动和声音检查不同,不能拿一张漫画分格表直接当作已经完成的视频制作方案。
第二步:把心理描写改成观众看得见的动作
“林非常纠结”只说明作者的想法。可以改成:“林看向即将关闭的车门,再看向寻找包裹的旅客,随后迈步离开列车。”观众通过视线和动作理解选择,不需要额外解释。
本例的场景稿是:发车提示响起,林从长椅上捡起包裹。站台另一侧的旅客正在翻找空布袋。林看一眼车门,转身把包裹送回去。列车离开,旅客打开包裹,露出一把黄铜钥匙。钥匙上的缺口,与林挎包的扣件形状相同。
对白只保留两句:“这是您的吧?”“看来,你没有来晚。”后一句并不解释所有秘密,而是为下一集留下具体问题。
先朗读并计时,再调整文字。停顿、观察和递交动作都要占用时间,不能只计算台词的阅读长度。需要双栏结构时,可以使用视频脚本模板,分别安排画面和声音。
第三步:确定人物和场景参考
林的固定信息包括短黑发、沙色外套、青绿色斜挎包和特殊黄铜包扣。旅客穿深灰色外套,提红色布袋。固定特征和临时状态要分开:角色可以在不同镜头中紧张或微笑,但不能无缘无故换外套、改变包的背法。
再画一张简单站台地图:长椅在左、列车在右,旅客位于站台较远处。标出林跑动的方向和递包位置。地图用于统一空间,不是美术成图。
不同生成工具接受的参考材料不同,需要查看当期文档。Runway 的图像参考文档介绍了参考图工作方式,但不能据此保证任意输出一致。具体审核可按人物一致性清单逐镜执行。
第四步:把一分钟拆成可以复核的分镜
下面八个剪辑段落合计恰好 60 秒。这里的时长是时间线分配,不是某个供应商支持的生成片段长度;一个段落可能需要多个短素材或静帧停留组合。
| 镜号 | 时间 | 观众获得的信息 | 声音 |
|---|---|---|---|
| 01 | 0—6 秒 | 站台全景,列车右、长椅左、旅客在远处 | 发车提示 |
| 02 | 6—12 秒 | 林发现长椅上的包裹 | 包装纸摩擦 |
| 03 | 12—19 秒 | 旅客翻找空红布袋 | 提示音继续 |
| 04 | 19—27 秒 | 林看向车门,再看旅客,迈步离开列车 | 短暂停顿 |
| 05 | 27—38 秒 | 林经过站台,递回包裹 | “这是您的吧?” |
| 06 | 38—46 秒 | 列车从林身后离开,选择代价明确 | 列车声渐弱 |
| 07 | 46—54 秒 | 旅客打开包裹,露出钥匙 | “看来,你没有来晚。” |
| 08 | 54—60 秒 | 钥匙缺口与包扣对应 | 环境声收低 |
审核时问每镜为什么存在。03 证明旅客在找东西,04 展示选择,06 呈现代价。删掉其中一镜,就必须找其他镜头承担同样的信息,而不是觉得“观众应该猜得到”。
现有分镜模板可以作为起点,但它默认展示产品视频结构。做这集故事时,需要复制为八格,并把商业阶段标签改成剧情信息,不能原样套用广告节奏。
第五步:按镜号生成素材,保留选择记录
给每个镜头固定编号,把提示词、参考图、生成结果和采用版本放在一起。04 镜的任务包应包含林的外观参考、站台位置、画面景别、两个视线目标,以及最后“离开列车”的动作。
可以先做少量诊断镜头:建立场景的远景、容易变形的角色角度、关键钥匙特写。确认这些任务能达到预期,再完成其余镜头。这是本例的审核建议,没有声称某模型因此能节省多少费用。
返工记录要写原因:“包的颜色错了”“跑动方向反了”“递交动作没发生”,比“效果不好”有用。人物特征出错回到参考资料,空间混乱回到分镜,单帧变形处理该素材。每次都重写整个剧本,会失去比较修改效果的依据。提示词结构详见AI 分镜规划。
第六步:先看粗剪,再精修单帧
先用静帧、粗运动和临时声音拼出时间线,按最终竖屏构图检查。包裹、旅客、车门和钥匙在裁切后都应清楚。横屏参考图并不一定能靠裁切解决,有时必须重新安排主体。
分三次看:第一次静音,看选择与空间是否成立;第二次只听声音,检查台词速度和声音跳变;第三次合起来看,判断声音是否加强了选择和揭示。
插入一个反应镜头,就要重新计算总时长。台词说不完时,可以删掉重复信息或改台词,不要把全部镜头均匀加速成一团。
第七步:让问题回到正确的环节
故意看一个错例:林拿起包裹,下一镜旅客微笑,最后列车驶离。观众没看见递交,也没看见林为什么没有上车。提高分辨率不能补上这条因果链,需要补旅客寻找、林转身和递包的动作。
| 问题 | 回到哪里 | 具体修改 |
|---|---|---|
| 不知道包裹是谁的 | 剧本、分镜 | 增加旅客翻找空袋的证据 |
| 人物像瞬移 | 分镜、剪辑 | 补方向一致的运动桥接 |
| 外套忽然改变 | 参考、生成素材 | 重用正确参考,替换错误版本 |
| 钥匙看不清 | 构图、剪辑 | 重新安排插入特写,复核裁切 |
| 总时长超标 | 剧本、时间线 | 删重复信息,再重新计时 |
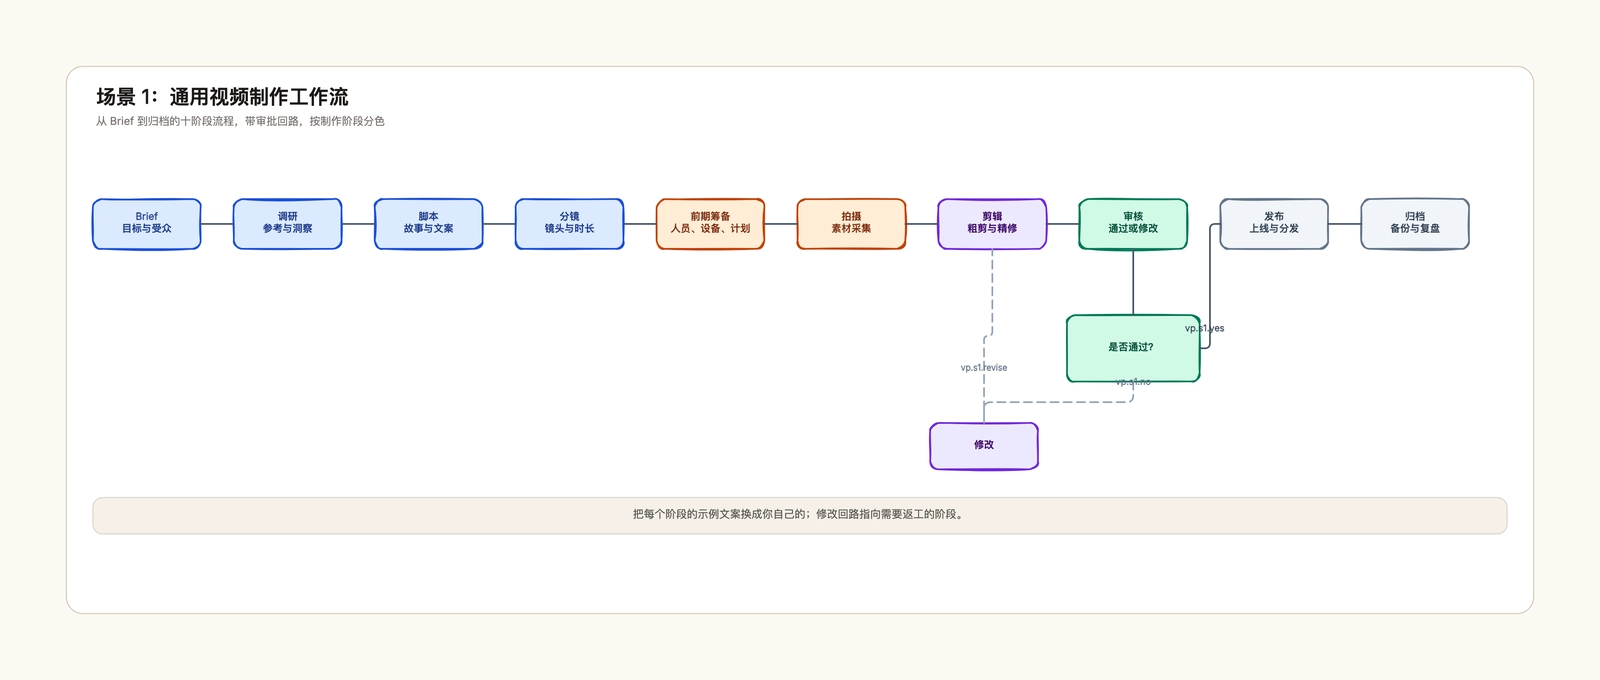
可以把这些交接放进视频制作流程模板。即使一个人完成所有角色,也要写清每一步交出什么、通过什么检查才能继续。
第八步:整理交付,而不只保存最后一个文件
按版本保留采用剧本、人物参考、镜头表、素材、音频和成片。记录目标发布平台需要的导出条件,再查该平台当前规则。本文不提供适用于所有平台的上传规格,也不把模板当作版权许可。
交付前确认:主线与简报一致,台词听得清,临时音频和参考图没有误入成片,最后一镜真正留下了下一集的问题。失败镜头记录可以帮助下次制作,但单个失败不能证明整个模型好或坏。
扣子官方漫剧教程展示了覆盖多个生成环节的服务实例;本文原创案例独立于该服务。CodePic 在这里承担可编辑策划画布的作用,生图、视频生成、配音和最终剪辑由相应工具完成。