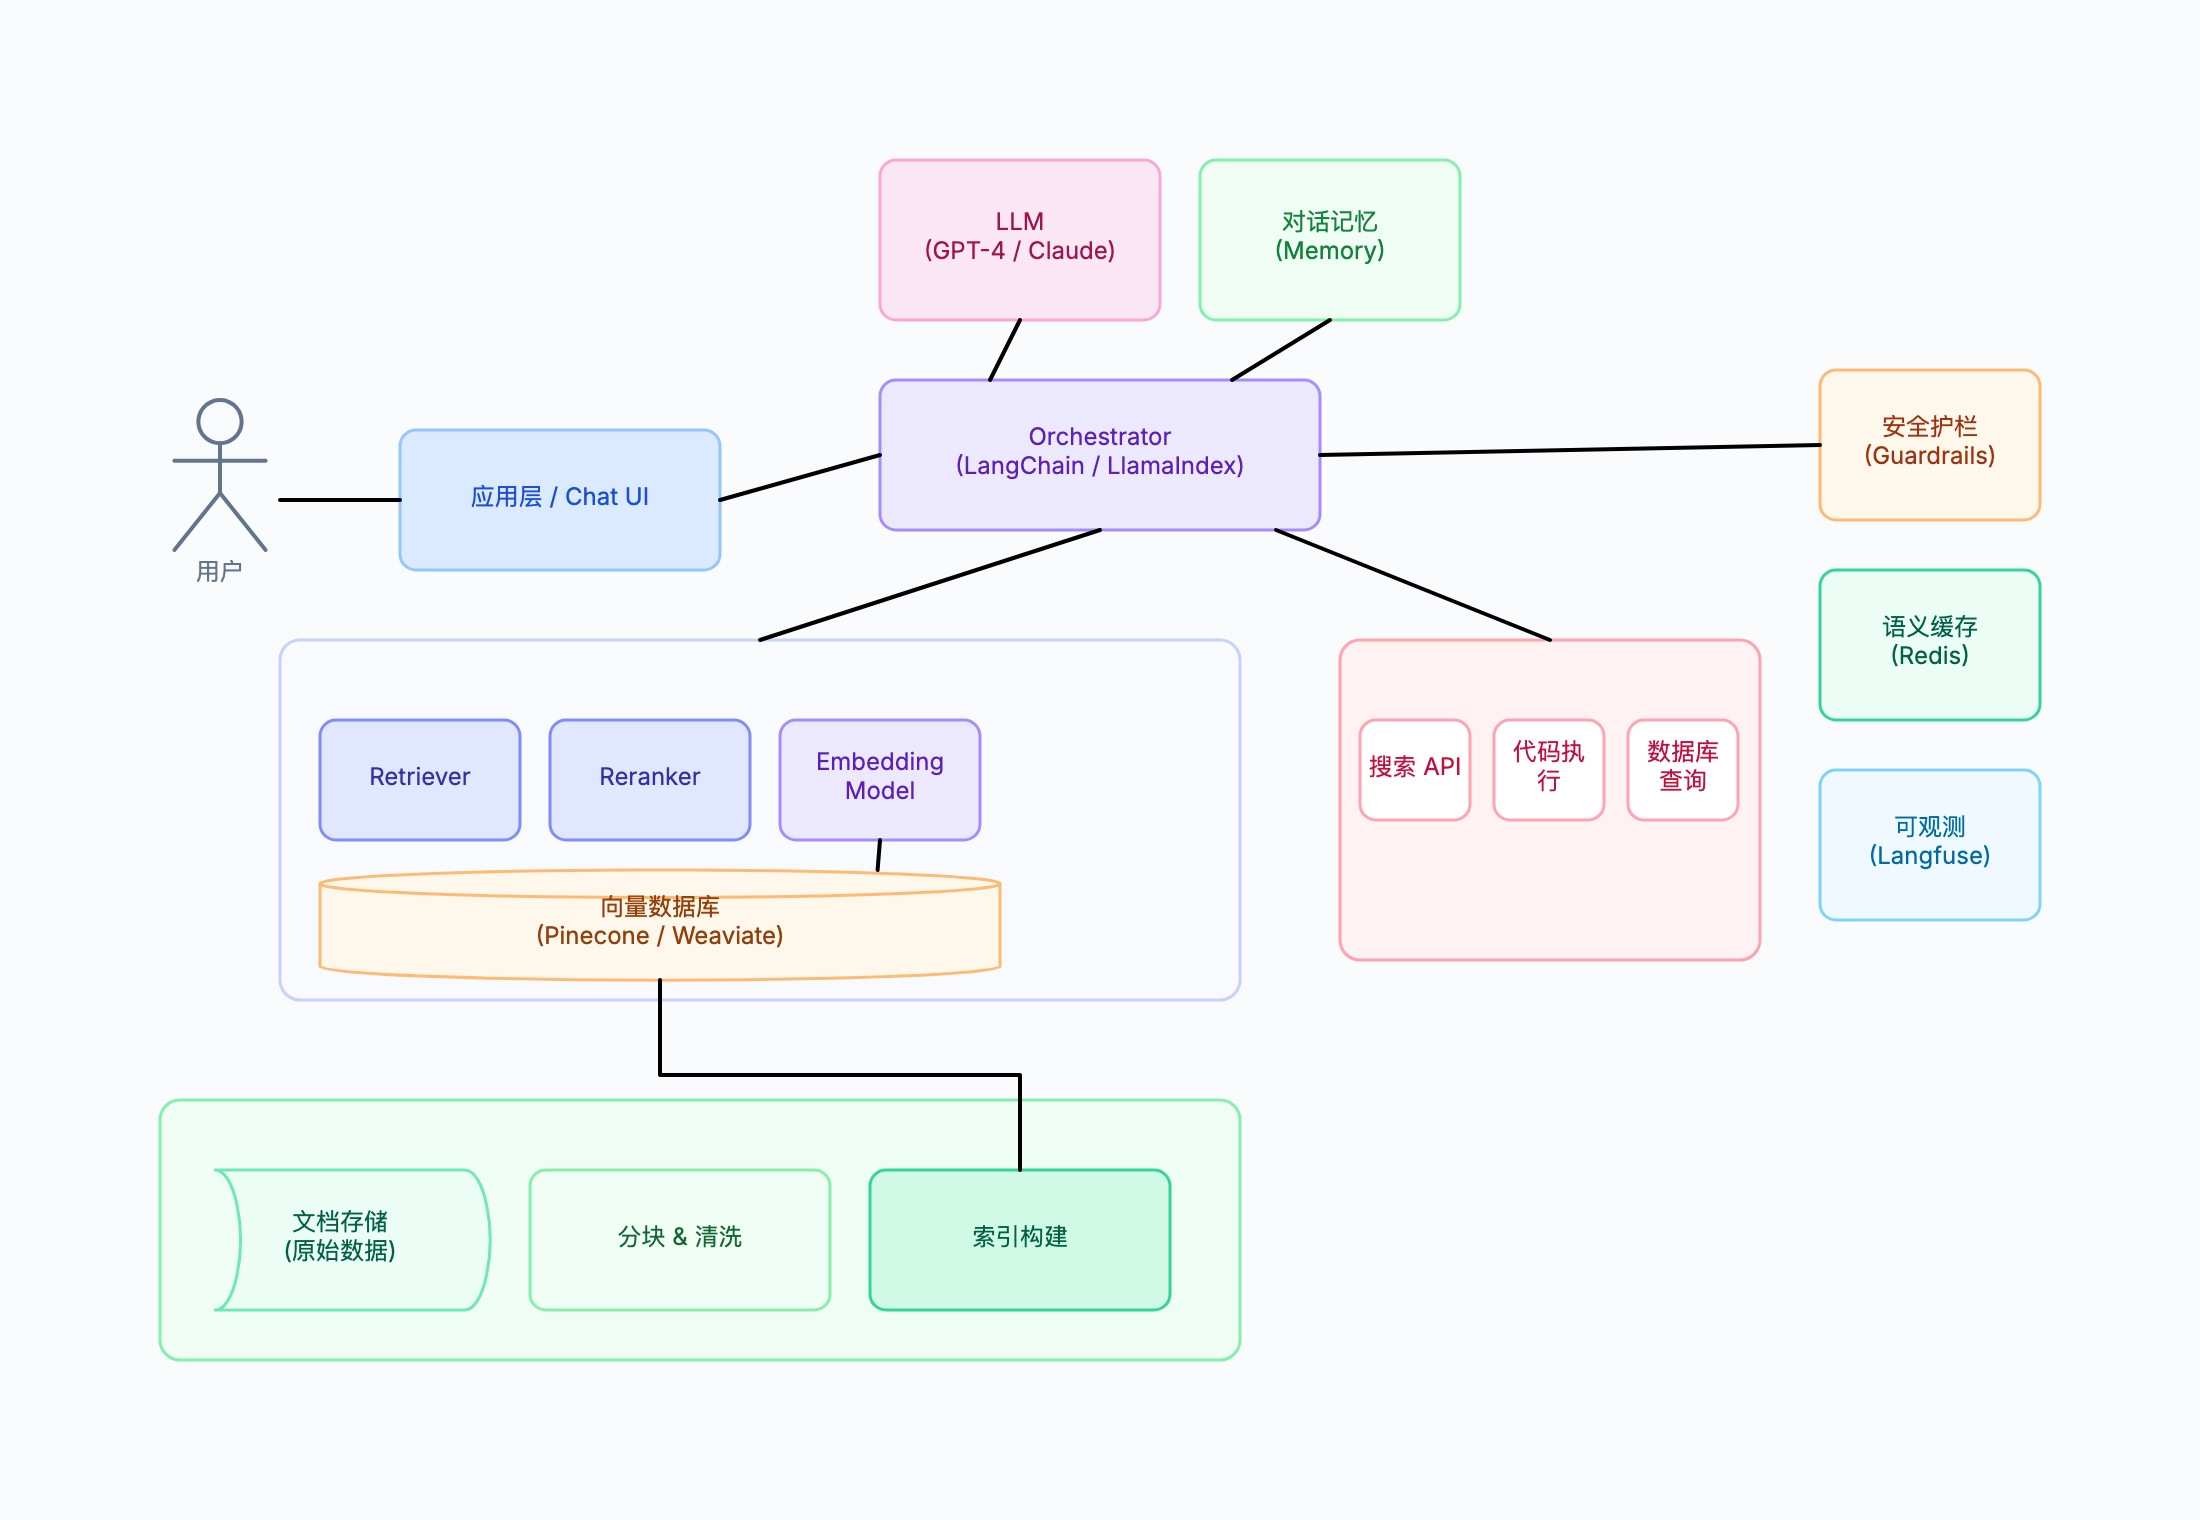
企业内部文档问答系统(RAG)
使用场景: 构建内部知识库聊天机器人的 ML 工程师
这样组织的原因: 企业级 RAG 需要完整的技术栈:护栏阻止敏感数据到达 LLM,重排序在大规模语料库中提升精度,按部门的成本追踪帮助证明基础设施投入的合理性。
以下示例展示了不同团队如何用相同的核心构建块(编排器、LLM、向量存储、工具)组装出不同类型的 AI 系统,帮助你理解各组件的组合方式并套用到自己的项目中。

使用场景: 构建内部知识库聊天机器人的 ML 工程师
这样组织的原因: 企业级 RAG 需要完整的技术栈:护栏阻止敏感数据到达 LLM,重排序在大规模语料库中提升精度,按部门的成本追踪帮助证明基础设施投入的合理性。
使用场景: 构建代码审查和生成助手的开发者工具初创公司
这样组织的原因: 代码助手适合用 ReAct Agent 循环,因为一次代码生成任务往往需要多次工具调用——获取文件、理解 Diff、查找相关测试——LLM 才能给出有用的响应。
使用场景: 构建课程学习伴侣的 EdTech 创业团队或计算机专业学生
这样组织的原因: 学生项目不需要完整的企业级技术栈——展示精简版本有助于明确哪些组件是必须的(LLM、向量存储、编排器),哪些是可以后期添加的生产级关注点。
RAG 是固定路径:先检索、再生成。Agent 架构存在循环——模型自己决定下一步调用哪个工具,而且可能调用很多次。这是图上最需要区分清楚的一点,因为「有循环」意味着成本和延迟不封顶,而固定流程不是。
传统组件是确定性的:同样输入得到同样输出。而 LLM 调用是概率性的,它的失败方式往往不是报错,而是「非常自信地给出错误结果」。所以 AI 架构图必须在传统图不会关注的位置画出校验、护栏和降级路径。
两者读者不同,不该画在一张图里。训练流水线涵盖数据采集、标注、微调、评测,偶尔运行一次;推理架构描述每个用户请求发生什么,持续在跑。混在一起会让人分不清哪些环节在延迟关键路径上。
很多线上系统会把简单请求路由到小模型、困难请求交给大模型。如果实际有路由而图上只画一个 LLM 方框,读者对成本和延迟的估算会严重失真。请把路由器画成独立的判断节点,并标出路由依据。
一个写着「LLM」的方框,把决定系统行为的东西全藏住了:系统提示词、注入了哪些上下文、工具定义、输出解析。至少要把提示词拼装和响应校验拆出来——绝大多数 bug 实际就出在这两处,所以它们恰恰是图最该暴露的部分。
很多图直接画「查询 → 向量库 → 结果」,把 embedding 模型省了。但 embedding 模型在两个位置都是硬依赖:建索引时和查询时,而且两处必须用**同一个**模型。省掉它,就藏住了检索质量悄悄变差的最常见原因。
在 AI 系统里,成本和延迟是架构属性,不是实现细节——串行调用三次 LLM 的设计和只调一次的设计,是两个完全不同的产品。请在每个 LLM 环节标出大致的 token 成本和延迟,这样这张图才能支撑真正的设计决策。
向量检索返回的是按相似度排序的近似最近邻,不是精确匹配。画得和 SQL 数据库一模一样,会暗示这是确定性查找,让读者期待系统给不出的保证。请在检索环节标注 top-k 和相似度阈值。
对一个 LLM 应用来说:入口、提示词拼装(含注入了哪些上下文)、模型调用、输出校验,以及校验失败时的降级路径。如果加了检索,还需要 embedding 模型和向量库。这几块基本覆盖了线上故障实际发生的位置。
把循环画一次,并明确标出退出条件——最大迭代次数,或者终止判断——而不是把几轮展开画成一长串。退出条件是评审最关心的部分,因为没有退出条件的 Agent 就是一个成本不设上限的风险。可用工具列在循环旁边,而不是塞进循环里面。
标层级和理由,而不是只写一个几个月后就过期的版本号。「分类用小模型、最终回答用大模型」这种描述能跨越模型升级,还顺带解释了设计意图。精确版本号应该固定在配置里,而不是写在一张希望长期有效的图上。
模型调用的前后都要有,而且两边检查的东西不同。输入侧处理提示词注入和不允许的请求;输出侧处理幻觉、格式校验和敏感内容泄漏。只画一侧是很常见的缺口,评审时一定会被问到。
要区分层级,因为它们行为不同:精确匹配的响应缓存、按 embedding 相似度命中的语义缓存、以及模型服务方提供的 prompt 缓存。标清你指的是哪一种、以及什么情况下失效——语义缓存可能返回「相似但错误」的答案,这个风险精确缓存是没有的。
回到模板页,替换成你自己的内容,就可以继续使用这套结构。
使用这个模板: /editor/new?template=ai-pipeline
编辑此 AI 架构图模板